
Dwarkesh 走進 Intel 晶圓廠:技術長說全球設備只夠讓先進製程產能翻倍,AI 算力每年卻要三倍
站長
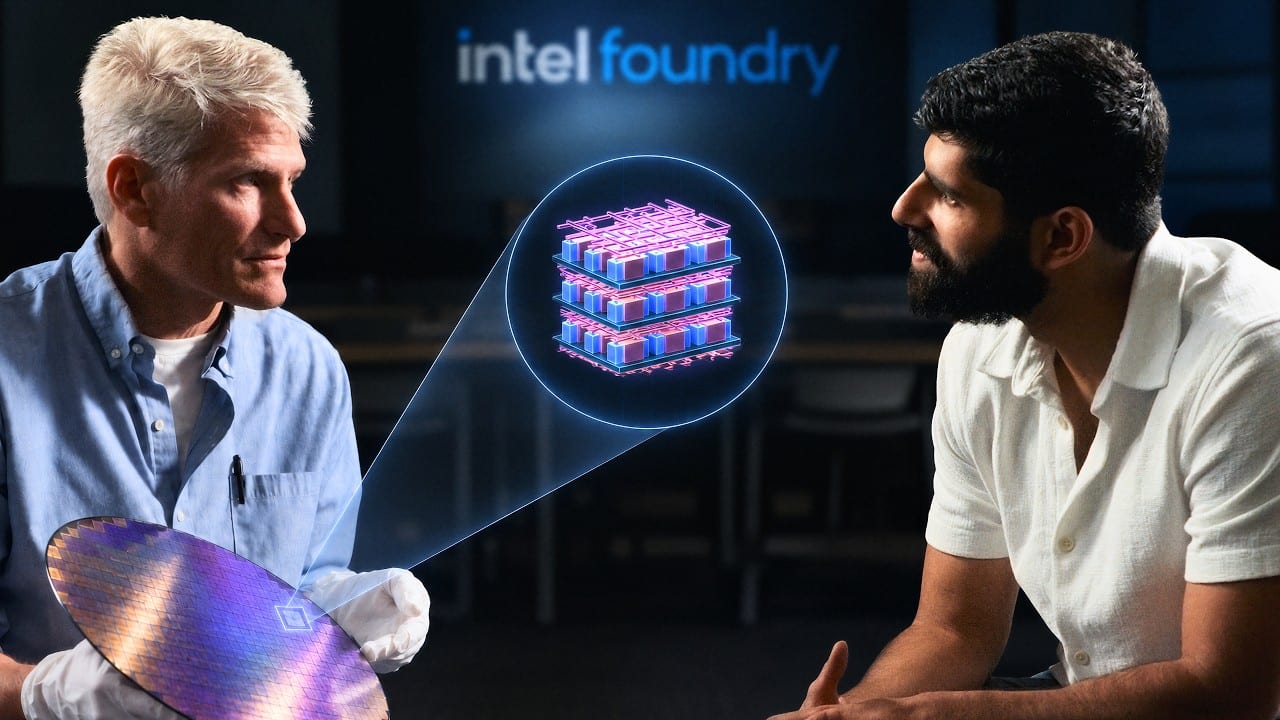
Dwarkesh Patel 這集換了做法:他花兩天走進 Intel 最先進的晶圓廠,從研發實驗室、封裝實驗室一路看到產線的內部會議,再分別找負責製程、整合、材料、封裝的技術主管,以及 Intel 技術長 Pushkar Ranade 對談,還配上大量動畫說明。整集想回答兩個問題:未來二十年的晶片會長什麼樣子,以及面對 AI 帶來的需求衝擊,半導體產業到底能多快擴產。
學到的第一課:一個製程節點不要塞太多創新
Intel 製造開發副總裁暨總經理(VP and General Manager, Manufacturing Development)Chris Auth 把新節點的養成講得很具體。14A 已經開發三年多,現在正在定案製程與機台,整條產線大約兩千道工序,每一步都要調到能每週穩定跑上千片晶圓。良率提升靠的是線上量測找缺陷,再到產線末端做電性測試,把失效的晶片切片分析,回推缺陷出現在哪一層、哪一段流程。
他最直白的反省來自 10 奈米。當年 Intel 想用「hyperscaling」超車,在 EUV 還沒準備好的情況下,用各種創意繞過機台限制,結果製程與工程師的負擔都過重,原訂 2016 年推出,拖到 2018 年才量產。Chris Auth 的結論是,10 奈米最終仍是好技術,但最該留到下一代的就是 EUV 這件事,而 Intel 後來也建立了一套成熟度指標與分階段把關流程,達不到門檻的技術就延到下一代。TSMC 2019 年就把 EUV 導入量產,比 Intel 多了大約四年使用經驗,這段差距到今天仍看得見。
我覺得這段的價值在於,它把「Intel 為什麼掉隊」從抽象的管理問題,拉回到非常工程的取捨:每一代能承受多少創新,決定了能不能準時交貨,而晶圓代工客戶最在意的正是時程。
從平面電晶體到 gate-all-around,再到 2045 年
節目用動畫把電晶體演進交代得很清楚:閘極從只蓋住通道上方的平面結構,到三面包覆的 FinFET,再到四面包住的 gate-all-around。有趣的是,FinFET 與 gate-all-around 的概念幾乎同時在 1988、1989 年被做出來,量產時間卻相差十年。Chris Auth 的解釋是,只要還有更簡單的方法能推進效能,例如應變矽、high-K 金屬閘極,產業就不會提早去碰更難的東西;一旦要做,往往還得等設備商發明新機台、新氣體、新加熱座。
他自稱是「電晶體迷」,認為 2000 年後反而是創新的黃金時代:過去的原則是盡量不要改,現在是拿大槌把整個流程拆掉重想,使用的材料種類大概多了十倍。他也提醒,業界常因為「五年內做不到」就否定一個方向,但若把時間拉到 2045 年,像記憶體那樣的立體堆疊結構很可能出現在邏輯晶片上。真正的限制是散熱,邏輯晶片耗電比記憶體高得多,堆起來熱散不出去。
High-NA EUV:同一台機器,Intel 與 TSMC 算出不同答案
High-NA EUV 一台價格約是一般 EUV(約 2 億美元)的兩倍,能少跑幾次曝光。TSMC 認為目前不划算,Intel 卻在 14A 採用。Chris Auth 給的理由很關鍵:Intel 有背面供電,把粗的電源線移到晶圓背面,正面訊號線不必排那麼密,一次 High-NA 曝光就夠;TSMC 沒有背面供電,線距更緊,就算用 High-NA 也得多次曝光,划不來。所以同一台機台的經濟效益,取決於整套製程架構。
另一個值得注意的轉變是 PDK(製程設計套件)。Intel 過去只幫自己做晶片,內部團隊直接交換電晶體數據,18A 一開始根本沒有正式 PDK,外部客戶用起來吃了不少苦頭。Chris Auth 坦承成為晶圓代工廠有學習曲線,14A 則會從第一天就提供高品質 PDK。
產線裡的 Hot Topics 會議與「共乘車道」
最有畫面感的一段,是 Dwarkesh 旁聽 Intel 的 Hot Topics 會議,由 Intel 互連與記憶體副總裁(Vice President, Interconnect and Memory)Kevin Fischer 主持,決定 18A 與 18A-P 的工程資源與實驗晶圓該往哪裡投。Kevin Fischer 說,一般工程師其實看不到每一天的延誤對營收和客戶的衝擊,他的工作就是決定要冒多少風險,因為等到資料完整,往往已經太遲。說到一半他還擔心自己會被剪成「把大家罵到發抖的怪物」,Dwarkesh 則回他這是很棒的名聲。
他舉的例子是磊晶時長出的「瘤」,會讓相鄰的源極汲極短路。團隊會同時追好幾條修法,有的是加一道特殊清洗把瘤去掉,有的是找出源頭根治。為了加速關鍵實驗,工廠還有分級的「hot box」,最高等級的 HotBox 1 在每台機台都享有優先權,像高速公路上清空一條共乘車道只讓一台車飆過去,代價是整座廠的機台效率被拖累,所以廠務人員都不太喜歡打這張牌。
研發實驗室:釕導線、CFET 與二維材料
在研發實驗室,Intel 院士暨元件研究副總裁(Fellow and Vice President, Components Research)Jack Kavalieros 解釋為什麼要研究電阻率比銅高的釕。銅導線需要一層類似黏著劑的襯墊才能沉積,線越細,襯墊佔的比例越大;釕可以直接蝕刻、不需要襯墊,大約在 20 奈米線距以下就會反超銅。他也笑看材料的輪迴:10 奈米時選了鈷,後來供應鏈找到方法讓銅重新勝出,未來也許輪到釕。
至於把 n 型與 p 型電晶體上下疊起來的 CFET,實驗室已經做出簡化版,但從可運作到放進手機還要大約十年。原因不在於特徵尺寸做不出來,而是堆疊之後的深溝蝕刻、填充、清洗都變難,上千道工序得全部對齊,效能還要超越現有的並排奈米片結構。很多新材料被淘汰的原因甚至很樸素:沉積得出來,但下一步的材料根本黏不上去。
混合鍵合:晶片之間的頻寬瓶頸
在封裝實驗室,Tyler Osborn 談混合鍵合。AI 工作負載常常卡在晶片之間搬資料的速度,而晶片面積成長快於邊長,運算力的成長自然跑在傳輸能力前面。混合鍵合把兩顆晶片的銅接點直接對準熔合,省掉焊錫凸塊,密度大幅提高。
Intel 量產中的 Foveros 接點間距是 25 微米,實驗室已經做到 10 微米以下,今年 IEEE ECTC 還有論文展示 0.45 微米間距的可靠度數據。Tyler Osborn 認為,間距一旦壓到 0.5 微米以下,甚至可以直接連接晶片內部較低層的導線。他也指出,邏輯對邏輯的堆疊比較適合先挑出良品晶粒再鍵合到晶圓上;非 AI 應用一樣受惠,因為更細的接點能降低每位元傳輸的功耗。
技術長的關鍵數字:工具只夠讓先進製程產能翻倍
整集最值得投資人記住的是 Pushkar Ranade 的回答。Dwarkesh 問,全世界的設備夠不夠讓先進製程晶圓產量成長十倍?他的答案是:不到十倍,大概兩倍。對照 AI 算力過去十年每年成長三倍,這個落差非常大。
他說 ASML 的 EUV 確實是瓶頸,但現在幾乎所有設備都缺貨;而且製程一旦定案,就被綁在特定機台、特定供應商上,無法臨時換。能做的是讓 18A 到 14A 之間大約八成的機台可以沿用,並從既有機台擠出更多產出,但良率已經很高時,每多 1% 都很難。
Dwarkesh 的歸納是:未來 12 個月的邊際產能可以增加得比預期快,但到 2030 年的總產量不會比現在的預測高多少。Pushkar Ranade 補充了時間軸:今天下大單買機台,約 18 個月到貨,已經是 2028 年;若還要蓋新廠房,就到這個十年的尾聲了。
他還提到一個結構性轉變:產業從三、四十年前的垂直整合,走到高度水平分工,現在又因為雲端巨頭自己設計晶片、模型公司一家就能吃下一整座廠的產能,正走向「虛擬的垂直整合」。Dwarkesh 粗算,Intel 端只要幾十億美元資本支出,產出的邏輯晶片就足以支撐 AI 模型公司每年上千億美元營收,價值顯然集中在堆疊頂端。
追趕 TSMC:技術差距不大,規模差很多
Pushkar Ranade 認為,晶圓代工是規模經濟最純粹的產業,建廠後約八成成本是固定的,每多一點稼動率和良率都是非線性的收益,這也是先進製程只剩三家的原因。TSMC 先進製程出貨量是 Intel 三倍以上,今年資本支出約 500 億美元,Intel 約 200 億美元。他的說法是技術上已經追上,只差幾個百分點,真正要追的是規模,而準時交貨、良率夠高以支撐快速放量,比多那幾個百分點更重要。Dwarkesh 引用 SemiAnalysis 數據說 14A 的電晶體密度大約只跟 N2 相當,他當場表示不同意這種比較方式。
談到 Intel 過去賣掉 DRAM 與快閃記憶體事業,他很乾脆地承認,事後看來大概不是賣掉快閃記憶體的最佳時機;他也認為今天記憶體的供給吃緊程度比運算晶片更嚴重。
Terafab:重新思考晶圓廠該怎麼蓋
最後談到 Intel 與 Elon Musk 的 Terafab 合作。Elon Musk 的立場很簡單:不蓋 Terafab 就沒有晶片,而他需要晶片。這背後的需求並不難理解:SpaceX 已經公開上市(代號 SPCX),xAI 是 SpaceX 的子公司,SpaceX 也已與 Cursor 合併,Elon Musk 的身家在 IPO 後達到 1 兆美元,旗下事業對算力與記憶體的胃口只會越來越大。Pushkar Ranade 說,晶圓廠不像造車那樣能自己摸索,所以 Intel 想協助加速 Terafab 的建置。
Dwarkesh 追問,既然設備才是瓶頸,新蓋一座廠是不是只是換人拿到保證產能,全球晶片總量並不會增加?Pushkar Ranade 回應,除了機台,晶圓廠還需要大量電力、水、耗材與無塵室空間。他接著丟出整集最大膽的想法:建廠成本大約每四到五年翻倍,微影成本漲得更快,一台 High-NA EUV 加上周邊設備約 4 億美元,照這條線畫下去並不合理。這個產業因為一次投入數百億美元而極度保守,新進工程師把流程當成教條,但我們真的還需要今天這種等級的無塵室嗎?
Dwarkesh 順勢開玩笑,提議在研究用的晶圓廠裡讓大家吃漢堡、抽雪茄,看看良率會怎樣。Pushkar Ranade 笑說那會是很棒的實驗,但 Intel、TSMC、Samsung 沒有一家會自願去做,也正因如此,有時從一張白紙重新開始反而是好事。收尾時 Dwarkesh 建議 Intel 應該像 Nvidia 鎖定記憶體那樣,趁現在大舉下單買機台,否則幾年後會看著幾兆美元的機會、但機台都在台灣。Pushkar Ranade 承認,如果早知道今天的狀況,一年前就會投資更多,接下來也會加碼。
我的看法
這集最有意思的地方,是它把「AI 算力能成長多快」這個問題,從 GPU 和模型的層次往下拉到機台、材料與工序。過去大家談瓶頸,多半停在 CoWoS 封裝、HBM 或電力,這集讓 Intel 技術長親口給出「設備只夠翻倍」的量級,等於提醒市場:算力需求的曲線和晶圓供給的曲線,在 2030 年前很難靠任何一家公司單獨拉近。
另一層訊息是 Intel 的定位。它在技術上用背面供電和 High-NA 押了一條與 TSMC 不同的路,但規模與 PDK 成熟度仍是硬傷;Terafab 合作則給了 Intel 一個不必完全靠自身資本支出就能擴大製造版圖的機會。對台灣讀者來說,Dwarkesh 那句「機台都在台灣」也說明,美國對先進製程在地化的焦慮會持續存在。
這對讀者代表什麼
- AI 算力的長期瓶頸愈來愈往上游移動,半導體設備、材料與無塵室空間的重要性,不亞於 GPU 本身。
- 未來一年產能可能比市場預期多一點,但到 2030 年的總供給受限於設備交期,晶片與記憶體偏緊的格局可能延續數年。
- Intel 的故事重點不在單一製程的密度比較,而在能否準時交貨、PDK 是否好用,以及能否爭取到大客戶與 Terafab 這類合作。
- 背面供電、gate-all-around、混合鍵合這些名詞會越來越常出現在財報與法說會上,理解它們有助判斷各家技術路線的差異。
未來投資可以留意的方向
- 半導體設備供應鏈:EUV 以外的蝕刻、沉積、量測、清洗設備同樣吃緊,可觀察相關廠商的訂單能見度與交期變化。
- 先進封裝與混合鍵合:鍵合設備、對準與檢測相關供應商,以及 Foveros 等平台的放量進度。
- 記憶體:技術長直言記憶體缺口比運算晶片更大,HBM 與 NAND 的報價與擴產節奏值得持續追蹤。
- Intel 晶圓代工:14A 的外部客戶簽約、High-NA 導入與資本支出是否上修。
- Terafab 與 SpaceX(SPCX)體系:觀察 Terafab 建廠時程、設備採購規模,以及 xAI 算力需求如何反映在供應鏈訂單上。
- 新材料與新製程:釕導線、二維材料、CFET 相關的材料與特殊氣體供應商,屬於較長期的布局題材。
來源(聽後整理)
- YouTube:https://www.youtube.com/watch?v=frYSOKvNiiE
- 主持人:Dwarkesh Patel(Dwarkesh Podcast)
- 受訪者:Pushkar Ranade(Intel CTO)、Chris Auth(Intel VP and General Manager, Manufacturing Development)、Kevin Fischer(Intel Vice President, Interconnect and Memory)、Jack Kavalieros(Intel Fellow and Vice President, Components Research)、Tyler Osborn(Intel 先進封裝技術開發總監)
非逐字翻譯、觀點整理,不構成投資建議。